検索
データウェアハウスとは?
目次
データウェアハウスとは、ビジネスインテリジェンス(BI)活動(主にアナリティクス、レポーティング、データマイニング)をサポートするために特別に設計された、大規模で一元的に保存されたデータのリポジトリです。トランザクション(レコードの挿入、更新、削除など)に最適化された運用データベースとは異なり、データウェアハウスは分析クエリのパフォーマンスに最適化されています。
データウェアハウスの説明
データウェアハウスは、組織内の複数のソースからの膨大な量の構造化データおよび半構造化データを格納、管理、分析するために設計された大規模な集中型リポジトリです。ビジネスインテリジェンスとレポーティングの基盤として機能するデータウェアハウスは、データ主導の意思決定と洞察を可能にします。
情報は、抽出、変換、ロード(ETL)と呼ばれるプロセスを通じてデータウェアハウスに到着します。データは、トランザクションデータベース、CRMシステム、外部データプロバイダーなど、さまざまなソースシステムから抽出されます。その後、データのクレンジング、正規化、集計を含む変換を行い、ウェアハウスのスキーマとの一貫性と互換性を確保します。最後に、変換されたデータはデータウェアハウスにロードされ、あらかじめ定義された列と行を持つテーブルなどの構造化された形式で保存されます。
データウェアハウスからのデータ検索には通常、SQL(構造化クエリ言語)やBIソフトウェアなどのツールを使用して、保存されているデータにクエリを実行します。ユーザーは、レポートの生成、アドホック分析の実行、またはビジュアライゼーションの作成により、洞察を得て意思決定を促進することができます。データウェアハウスには構造化されたデータが格納されており、組織や形式が明確に定義されているため、効率的なクエリや分析が可能です。
オンプレミスまたはクラウド
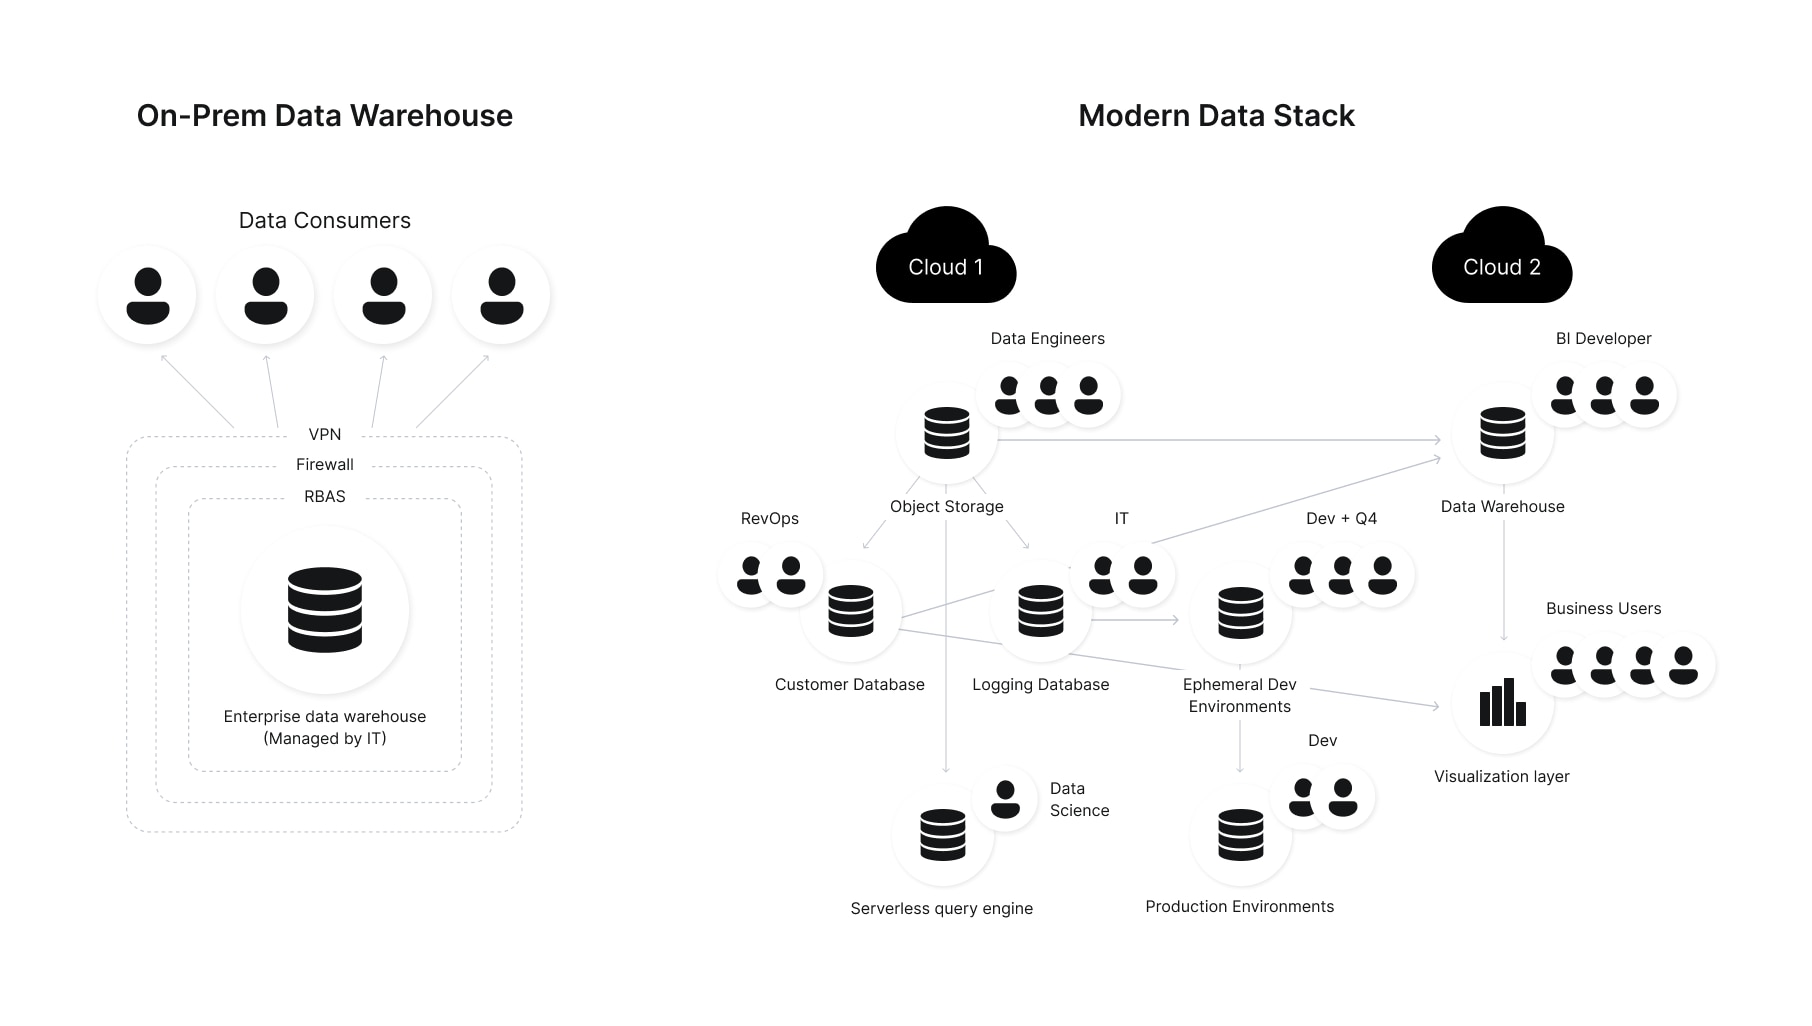
データウェアハウスはオンプレミスでもクラウドでもデプロイできます。オンプレミスのデータウェアハウスでは、組織がインフラストラクチャを管理・維持する必要があるため、データとリソースをより詳細に管理できます。Amazon Redshift、Google BigQuery、Snowflakeなどのクラウドベースのデータウェアハウスは、インフラストラクチャ、スケーラビリティ、およびメンテナンスを処理するマネージドサービスを提供しているため、組織はデータ分析に集中し、運用コストを削減できます。
データウェアハウスの特徴とは?
データウェアハウスは、大量のデータからの洞察の抽出を最適化するために独自に設計されています。サブジェクト指向の設計により、組織のデータの統合ビューを確実に提供し、組織は販売、財務、在庫などのドメインに集中することができます。さまざまな業務システムからのデータでは、データ型、命名、その他の規約の不一致のトラブルシューティングにおいて、統合が重要な役割を果たします。
もう1つの特徴は、データウェアハウスのサブセットである データマートの概念で、営業やマーケティングなど、個々の部門やビジネス機能に特化してデータを調整します。データウェアハウスが幅広い組織的なビューを提供するのに対し、データマートはより特定の分野に特化しています。特にスタースキーマやスノーフレークスキーマなどのスキーマ設計は、データの組織化をさらに洗練させ、最適なアクセス性と分析クエリのパフォーマンスを保証します。
デジタルの進化に伴い、データウェアハウスも新たなテクノロジーと融合しています。ビッグデータの出現により、多くの組織がデータウェアハウスを データレイクで補完するようになりました。これらを組み合わせることで、構造化データと非構造化データを取り込み、さらに広範な分析環境を提供します。
最終的に、データウェアハウスの主な目的は、多面的なデータソースが集まる環境を促進し、情報に基づいた意思決定に不可欠なクエリ、分析、および洞察の抽出のための豊富なプラットフォームを提供することです。

図2:従来のアーキテクチャの攻撃対象には、エンタープライズVPN、エンタープライズデータウェアハウス、部門データが含まれています。
データウェアハウスの利点とは?
データウェアハウスは、組織が意思決定プロセスを合理化し、業務効率を改善し、競争上の優位性を獲得するのに役立つさまざまなメリットを提供します。
統合データビュー
複数のソースからのデータを統合プラットフォームに統合することで、組織に業務と顧客に関する包括的なビューを提供し、より良い意思決定を可能にします。
ビジネスインテリジェンスの強化
統合されたデータを自由に活用することで、組織はさまざまなBIツールを使用して高度な分析、レポーティング、データマイニング、可視化を実行し、データから実用的な洞察を得ることができます。
歴史的分析
過去のデータを保存することで、組織は傾向を分析し、メトリクスが時間とともにどのように変化したかを確認することができます。これは、長期的なパターンやシフトを予測し、理解する上で非常に重要です。
データの品質と精度の向上
ETL プロセスは、データをウェアハウスに送り込み、データのクリーニングと変換を行います。これにより、アナリティクスとレポーティングに使用されるデータが正確かつ高品質であることが保証されます。
データウェアハウスによる時間短縮
データを一元化し、クエリのパフォーマンスを最適化することで、データウェアハウスは、複数の異なる業務システムにクエリを発行する場合と比較して、レポートの作成や分析の実行にかかる時間を大幅に短縮することができます。
ハイパフォーマンス
データウェアハウスは、クエリのパフォーマンスに最適化されています。複雑なクエリも高速に実行できるため、リアルタイムまたはそれに近い分析およびレポートが容易になります。
データセキュリティの強化
データウェアハウスには、 機密データを保護するための強固なセキュリティ機能が備わっていることがよくあります。これには、ユーザー アクセス制御、 暗号化、監査機能が含まれます。
データの一貫性
さまざまなソースからのデータを統合し、統一されたデータモデルを提供することで、データウェアハウスはデータ定義とフォーマットの一貫性を確保し、信頼性の高い分析とレポートを実現します。
意思決定支援
すべての関連データが一箇所に集められ、それを分析するツールがあれば、意思決定者は組織の目標に沿った、より多くの情報に基づいたデータ主導の意思決定を行うことができます。
スケーラビリティ
最新のデータウェアハウスは、データ量の増加に合わせて大規模化できるように設計されています。これにより、データウェアハウスは、パフォーマンスを損なうことなく、組織のデータニーズの増加に伴う負荷の増加に対応できるようになります。
コスト削減
データウェアハウスの構築には初期投資がかかりますが、データの管理と検索に費やす時間とリソースを削減し、より効率的な意思決定プロセスを可能にすることで、長期的にはコスト削減につながります。
データウェアハウスは、組織がデータを最大限に活用し、生データをビジネスの成長とイノベーションを促進する実用的な洞察に変換できるようにします。
データウェアハウスはいつ有益か?
データウェアハウスは、さまざまな業界でデータ主導の意思決定を推進する上で極めて重要な役割を果たしています。一元化され、構造化され、最適化されることで、無数の使用例が生まれます:
- ビジネスレポートと分析:組織はデータウェアハウスを使用して、月次の売上サマリーから詳細な財務諸表まで、通常のビジネスレポートをサポートします。
- 小売パーソナライゼーション:オンラインと店舗でのショッピングデータを統合し、パーソナライズされた商品レコメンデーションやマーケティングキャンペーンを提供。
- 医療成果分析:患者の治療記録を統合し、特定の疾患に対する最も効果的な医療介入を特定。
- 銀行詐欺の検出不規則なパターンや潜在的な不正行為を検出するために、口座全体の取引データを集計します。
- サプライチェーンの最適化:過去の購買・出荷データを最適化し、在庫の必要性を予測し、サプライチェーンプロセスを最適化します。
- カスタマーサービス強化:様々なタッチポイント(Eメール、チャット、電話)から顧客とのインタラクションデータを収集し、サービス改善やトレーニングの必要性を特定します。
- リアルタイムマーケティング分析:マルチチャネルのマーケティングキャンペーンをリアルタイムでモニタリングし、ユーザーエンゲージメントやコンバージョンの指標に基づいて、最大限の効果が得られるように戦略を調整します。
- エネルギー消費予測:スマート・メーターからのデータを地域横断的に集約してエネルギー消費パターンを予測し、電力会社のグリッド負荷管理を支援。
- Eラーニングの進捗管理:オンラインコースのデータを統合し、学生の進捗状況を評価し、コンテンツ配信を適応させ、学習成果を向上させます。
- 製造品質保証:生産ラインのデータを集約し、製品の品質を監視し、欠陥を早期に発見し、製造工程の一貫性を確保します。
包括的なデータ分析に基づく意思決定から利益を得る組織は、データウェアハウスの使用事例を見つけることができます。
データウェアハウスに関するFAQ
データウェアハウスは、分析やレポーティングを目的として、さまざまなソースからの大量のデータを一元化、統合、保存します。
Snowflakeはクラウドベースのデータウェアハウス・プラットフォームです。
データベースは、リアルタイムのデータ保存とトランザクション処理のために設計されています。一方、データウェアハウスは、分析クエリとレポーティングのために、さまざまなソースからの大量のデータを一元化し、最適化します。
休眠データとは、収集されたものの、分析されず、意思決定に利用されていないデータのことです。ある試算によると、組織が収集したデータの80%は眠ったままになっています。休眠データは構造化されておらず、管理されていないことが多く、クラウドやローカルストレージなどさまざまな場所に保存されています。休眠レコードやデータセットは、ビジネスソフトウェアアプリケーション(プロジェクト管理ツールなど)でも見つけることができます。/p>
休眠データは定期的に使用されることがないため、 データ・セキュリティに関しては、レーダーに引っかかる可能性があります。しかし、このデータには顧客情報などの機密情報が含まれている可能性があり、組織の広範なデータ保護戦略の一環としてカバーする必要があります。


